Ce qu'il faut retenir
- Screaming Frog SEO Spider est le crawler que j’utilise depuis mes débuts en SEO : il ouvre chacune de mes missions.
- Son métier, c’est l’audit technique : il détecte plus de 300 problèmes, et ses exports se retrouvent sans chercher.
- Le rendu JavaScript rend service sur les sites en JS, mais il n’est pas fiable à 100 %.
- Depuis la version 24, son MCP se branche dans Claude : c’est devenu ma façon principale de l’utiliser.
- La licence coûte 245 € HT par an et par utilisateur ; la version gratuite s’arrête à 500 URLs.
Screaming Frog est l’outil technique que tout SEO apprend en premier pour explorer un site, et il est dans ma stack depuis mes débuts. En tant que consultant en SEO technique, je l’ouvre au démarrage de chaque mission pour poser l’état des lieux : c’est le crawler de référence, à un prix très correct.
Ce test porte sur le SEO Spider en version 24.3, sortie le 29 juin 2026. Le Log File Analyser, l’autre logiciel de l’éditeur, a sa partie plus bas.
Screaming Frog en deux mots
Le SEO Spider de Screaming Frog est un crawler à installer sur ton ordinateur, sous Windows, macOS ou Linux. Il parcourt un site comme le robot d’un moteur de recherche et relève tout ce qu’il trouve, page par page.
L’éditeur, Screaming Frog Ltd, est une agence de marketing anglaise fondée en 2010 ; Dan Sharp, l’un de ses cofondateurs, a conçu l’outil (screamingfrog.co.uk, relevé le 5 octobre 2026). L’interface existe en français, mais la documentation n’existe qu’en anglais.
Mon usage : l’état des lieux de départ
Je lance Screaming Frog sur presque tous les sites, et surtout au début d’une prestation. Le premier crawl pose l’état des lieux et fait remonter les problèmes techniques qui se cachent dans le site.
Il me sert aussi sur le plan sémantique : balises title, titres et contenus trop proches se lisent dans le même tableau que les erreurs techniques.
L’audit technique, son vrai métier
Screaming Frog annonce plus de 300 problèmes SEO détectés. Un crawl te donne la liste de ce qui bloque, rangée par onglet :
- les codes de réponse (3xx, 4xx, 5xx), les redirections en chaîne ou en boucle et les liens que le robot ne peut pas suivre ;
- les canonicals, les balises hreflang, la pagination et les directives meta robots ou X-Robots-Tag ;
- les doublons exacts, et les quasi-doublons repérés à partir de 90 % de similarité, un seuil réglable ;
- les données structurées, validées selon Schema.org et selon les exigences des résultats enrichis de Google ;
- les Core Web Vitals, via l’API PageSpeed Insights, et l’accessibilité, contrôlée avec les règles AXE.
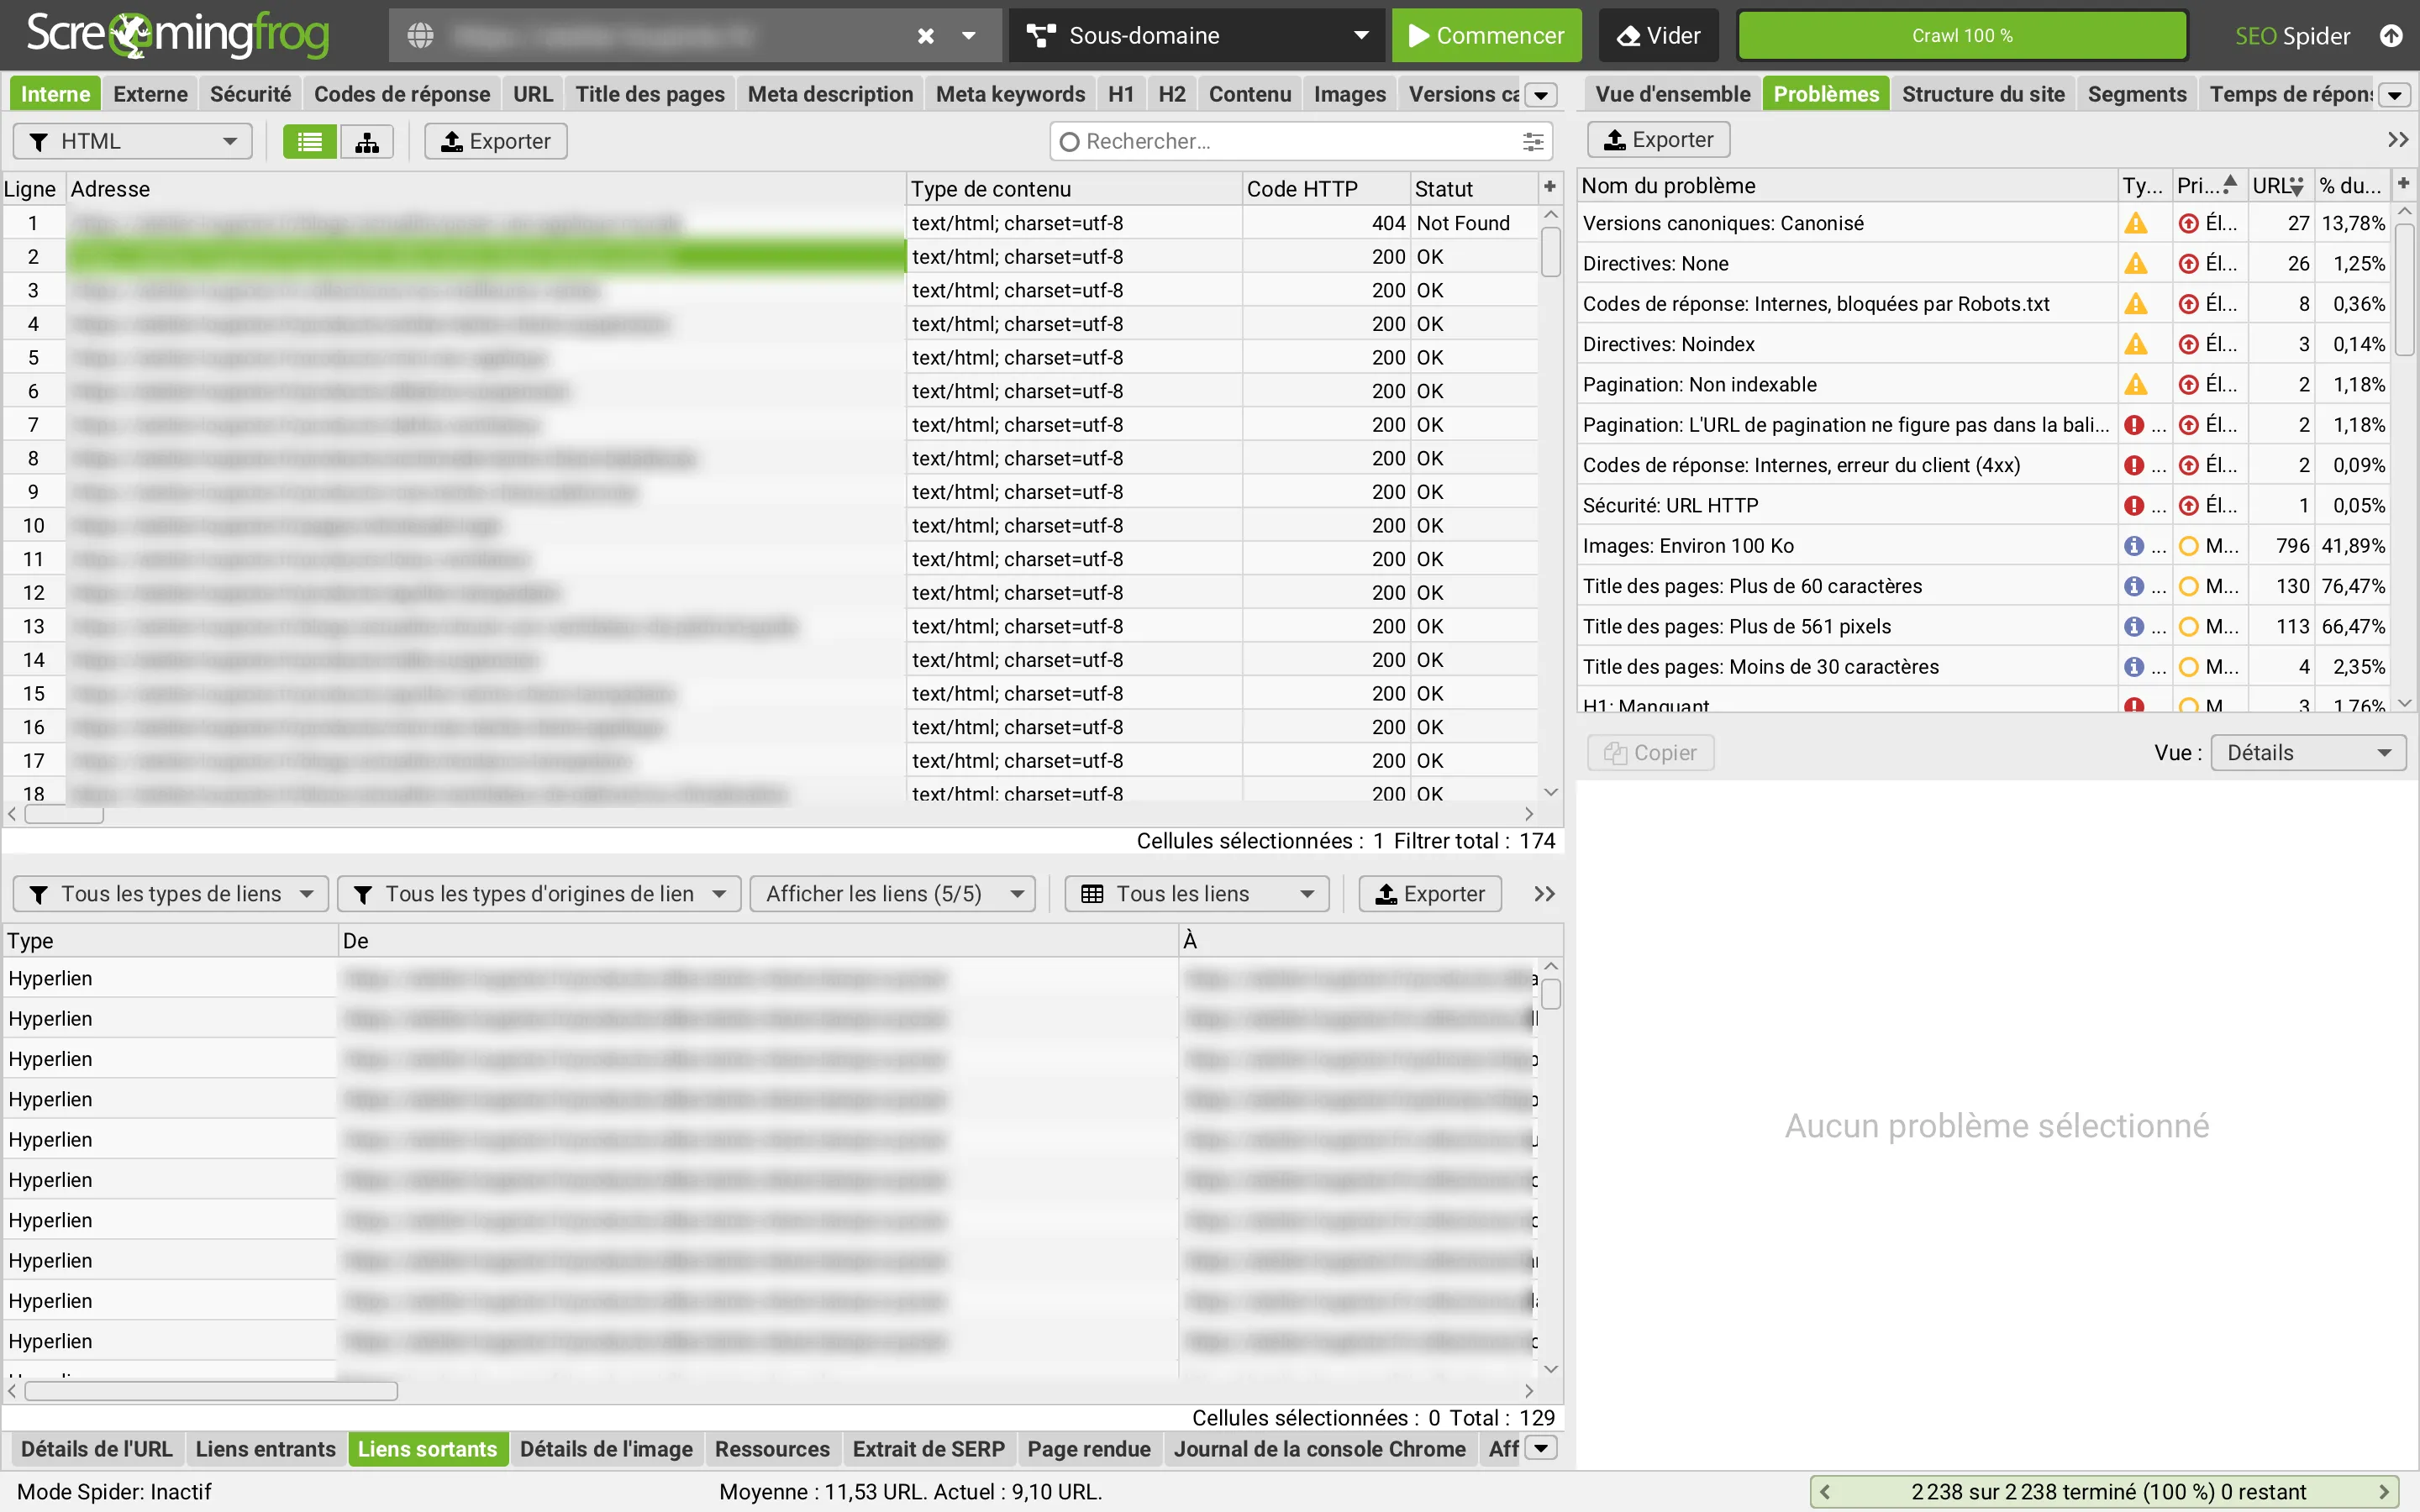
Ces contrôles avancés demandent la licence. La version gratuite couvre le diagnostic de base : liens cassés, redirections, balises title et meta, directives, hreflang et doublons exacts.
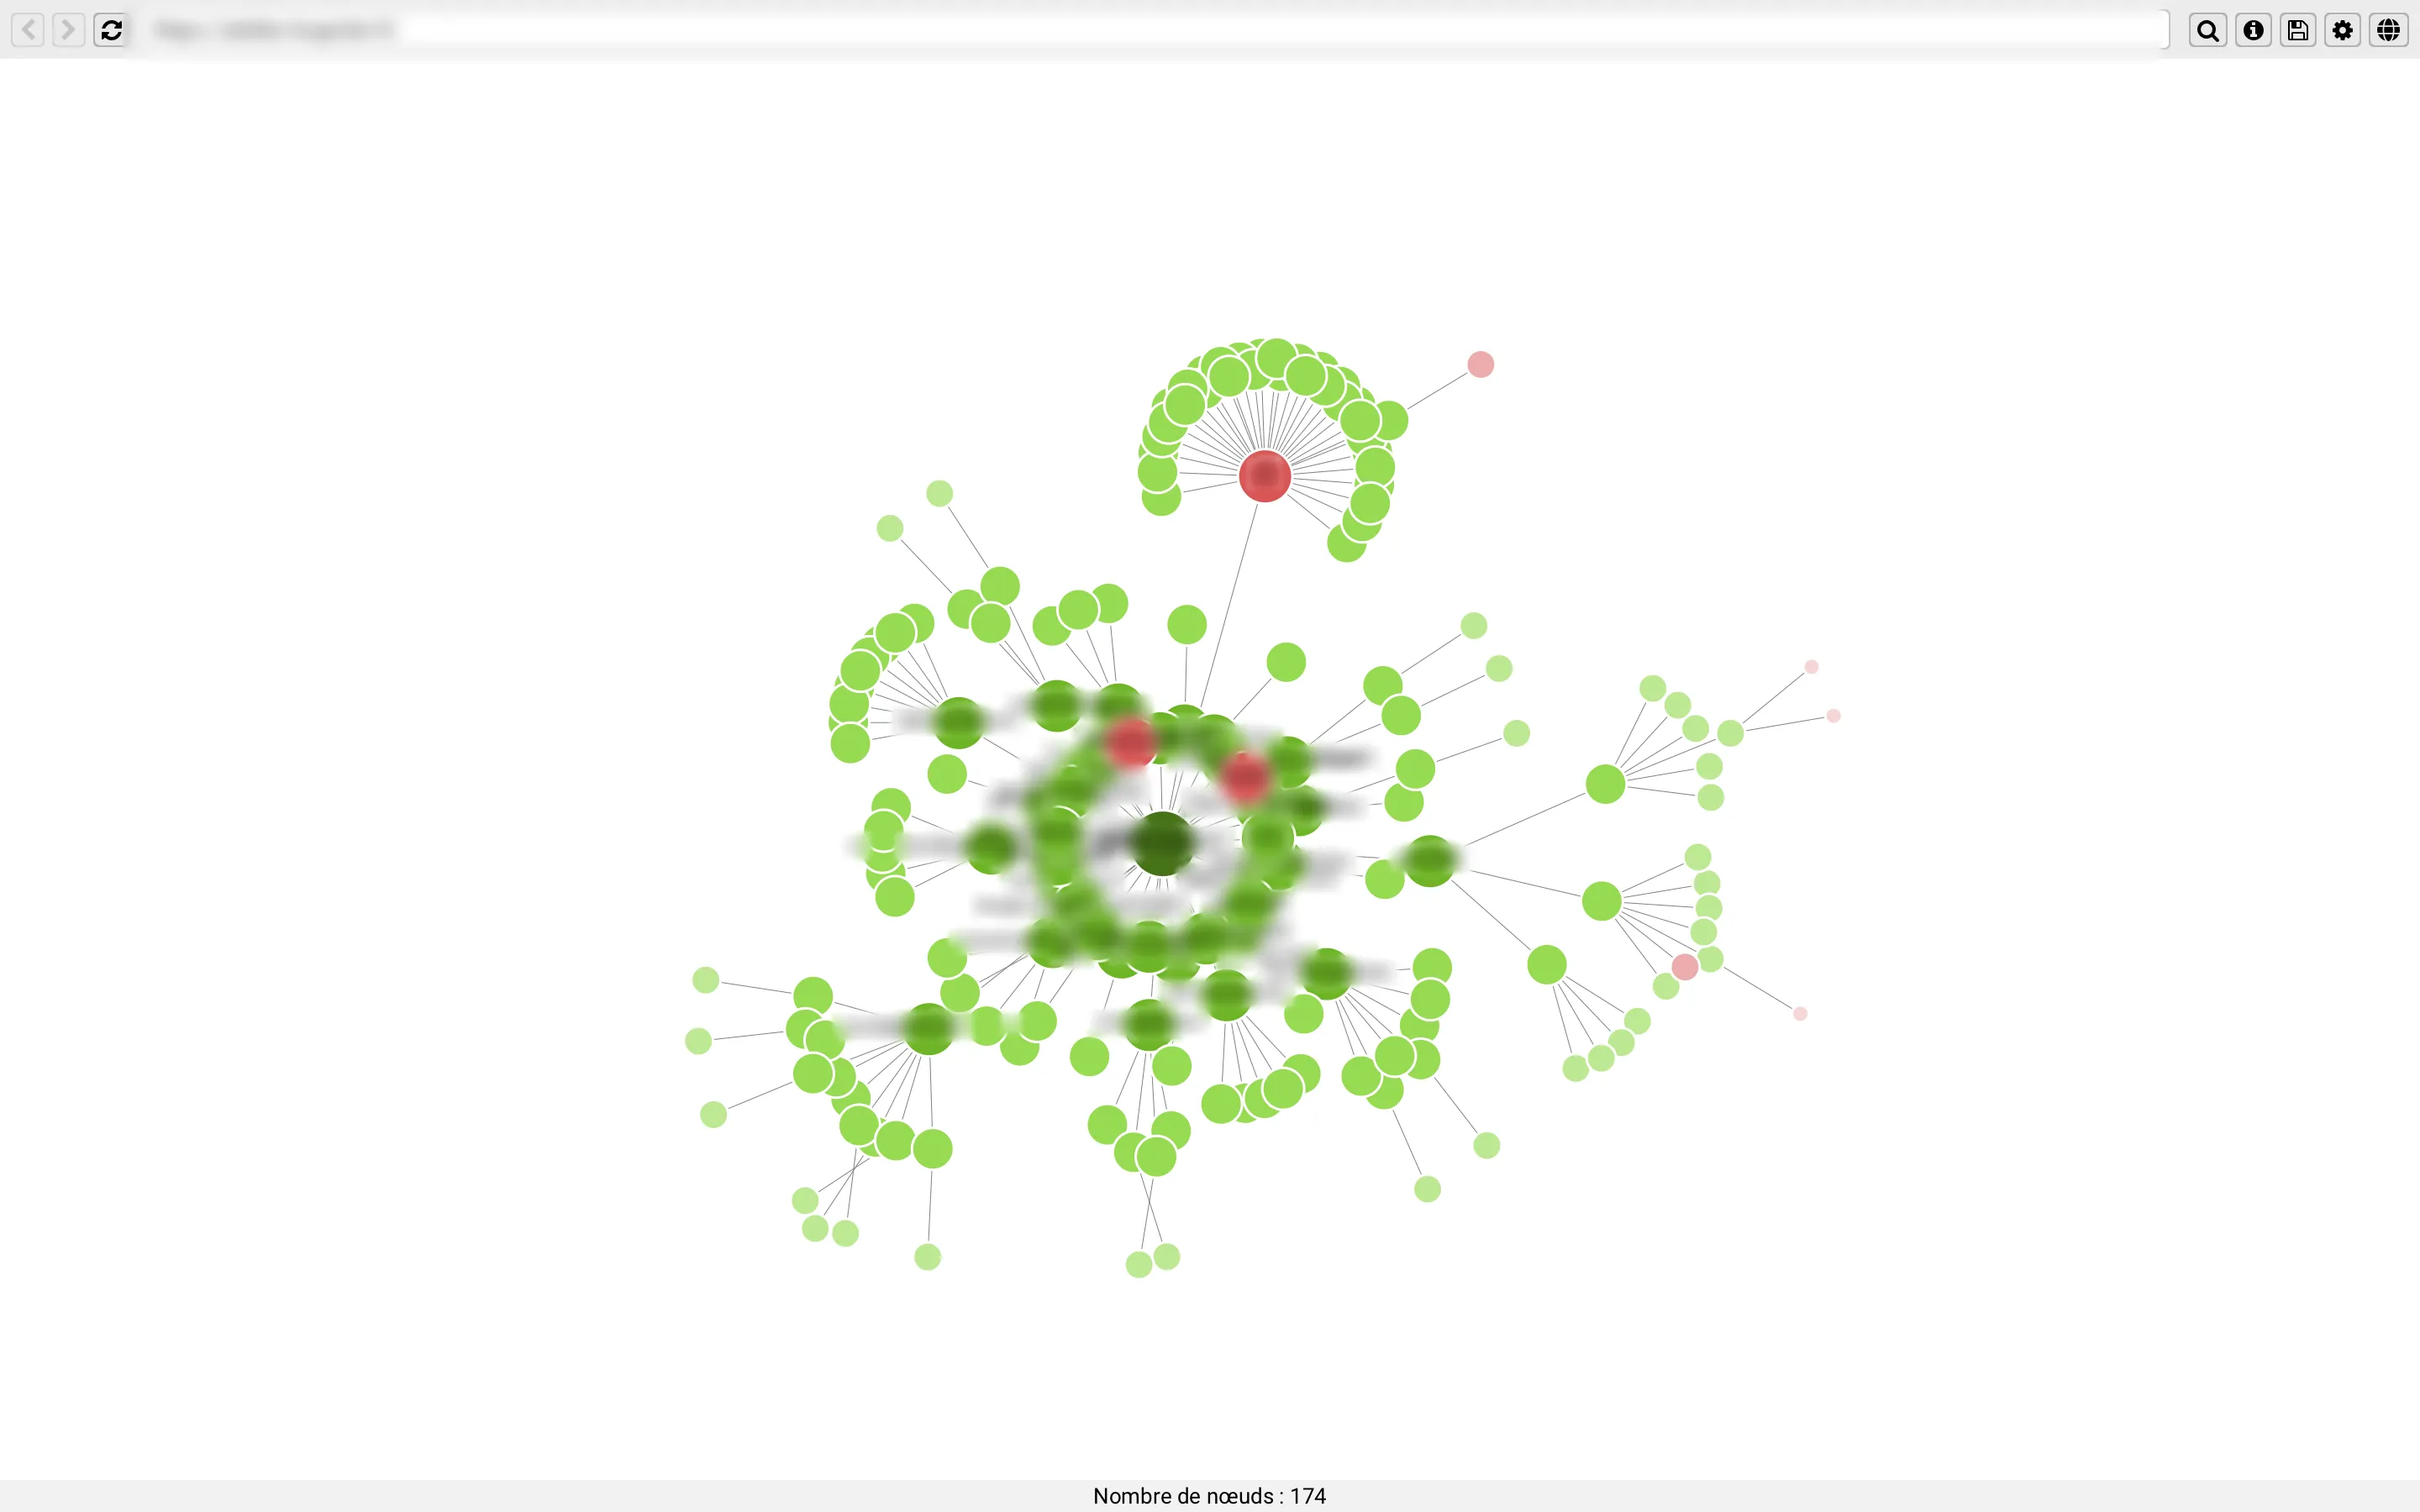
Les visualisations complètent la lecture : le diagramme de crawl dessine l’arborescence du site en graphe, et les pages non indexables y ressortent en rouge.
Le rendu JavaScript, pas infaillible
Sur un site construit en JavaScript, le rendu par Chromium, le navigateur sans interface que Screaming Frog embarque, crawle les pages telles qu’un navigateur les affiche. C’est comme ça que j’explorais les sites en JS, et il m’a rendu de vrais services.
Il lui arrive pourtant de mal rendre une page : ce rendu n’est pas fiable à 100 %.
Profils de crawl et exports
L’interface est bien pensée : on s’y retrouve, et la liste des exports se parcourt sans chercher. Le meilleur détail est la sauvegarde des paramétrages : tu enregistres une configuration pour un type de crawl précis, et tu la recharges au crawl suivant.
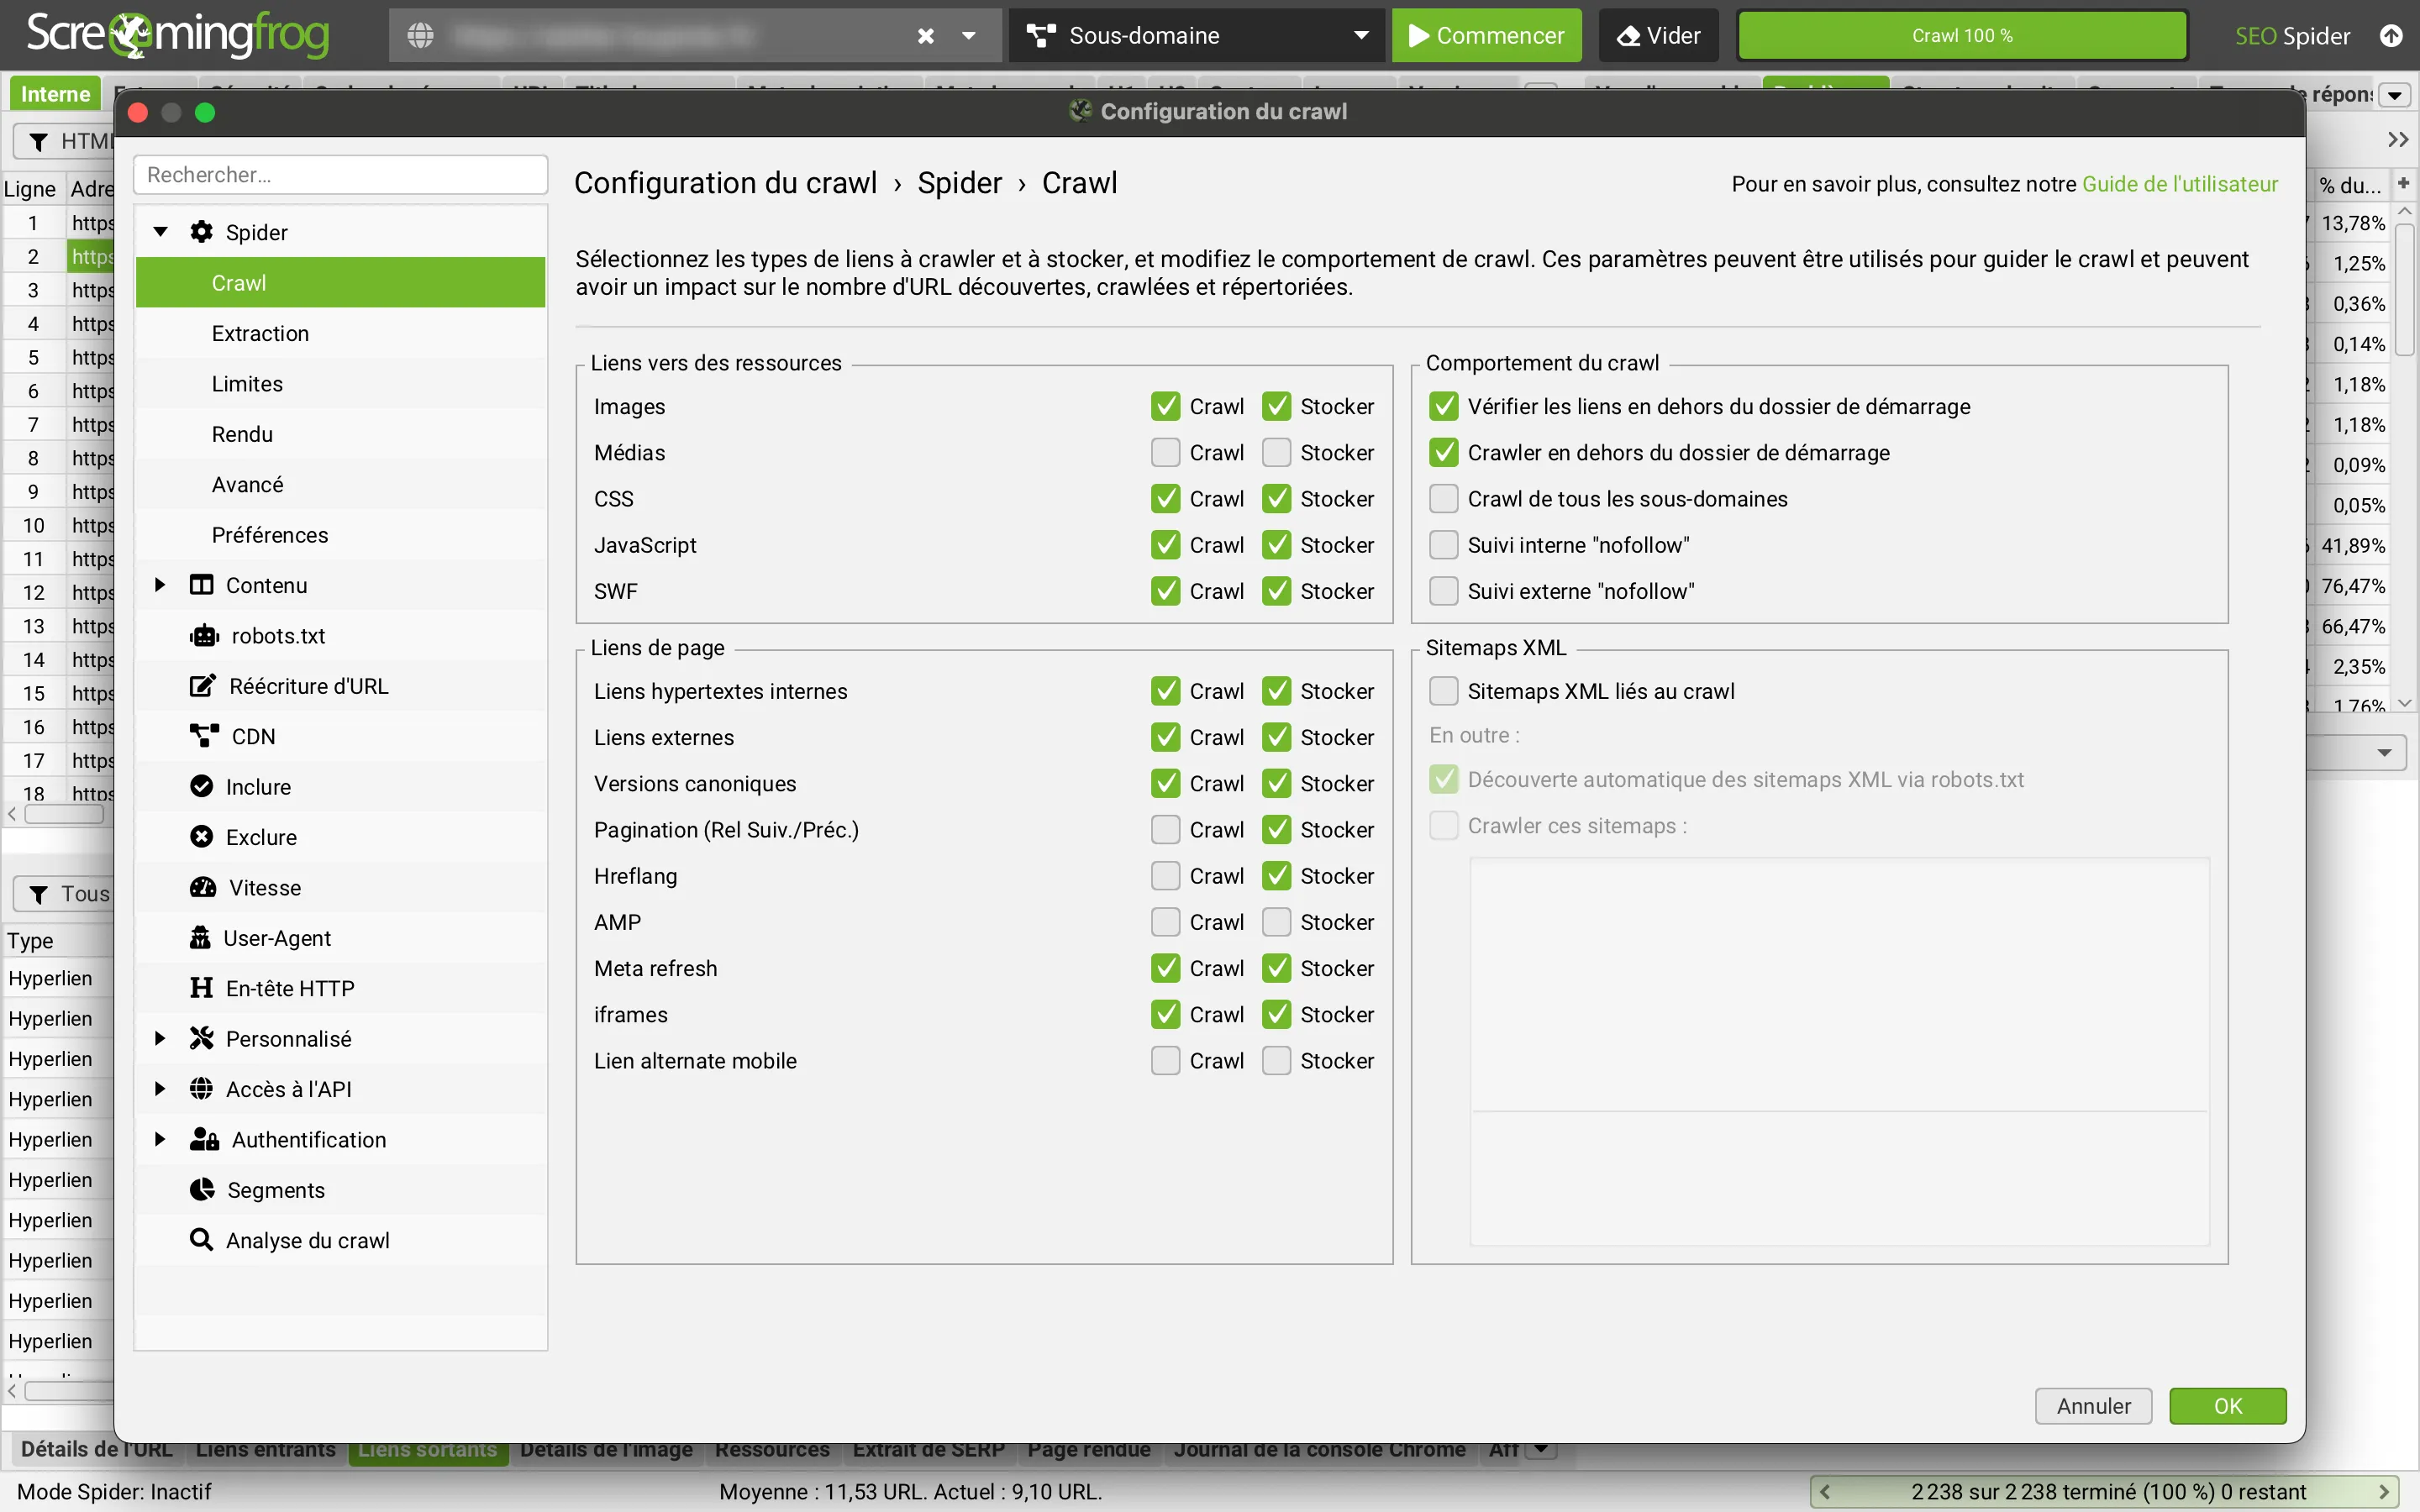
Pour aller plus loin, l’extraction personnalisée récupère n’importe quelle donnée d’une page, par XPath, sélecteur CSS ou expression régulière, et des snippets JavaScript agissent sur la page pendant le crawl. Les résultats partent en CSV, en Excel ou dans Google Sheets, et un rapport de crawl automatique alimente Looker Studio.
Les crawls se planifient, ponctuels ou à intervalles, avec l’envoi des exports par e-mail depuis la version 24. L’outil se pilote aussi entièrement en ligne de commande.
GA4, Search Console et PageSpeed
Screaming Frog croise le crawl avec tes données Google : GA4, Search Console, inspection d’URL comprise (2 000 URLs par propriété et par jour), et PageSpeed Insights. Côté liens, il interroge les API d’Ahrefs, de Majestic et de Moz.
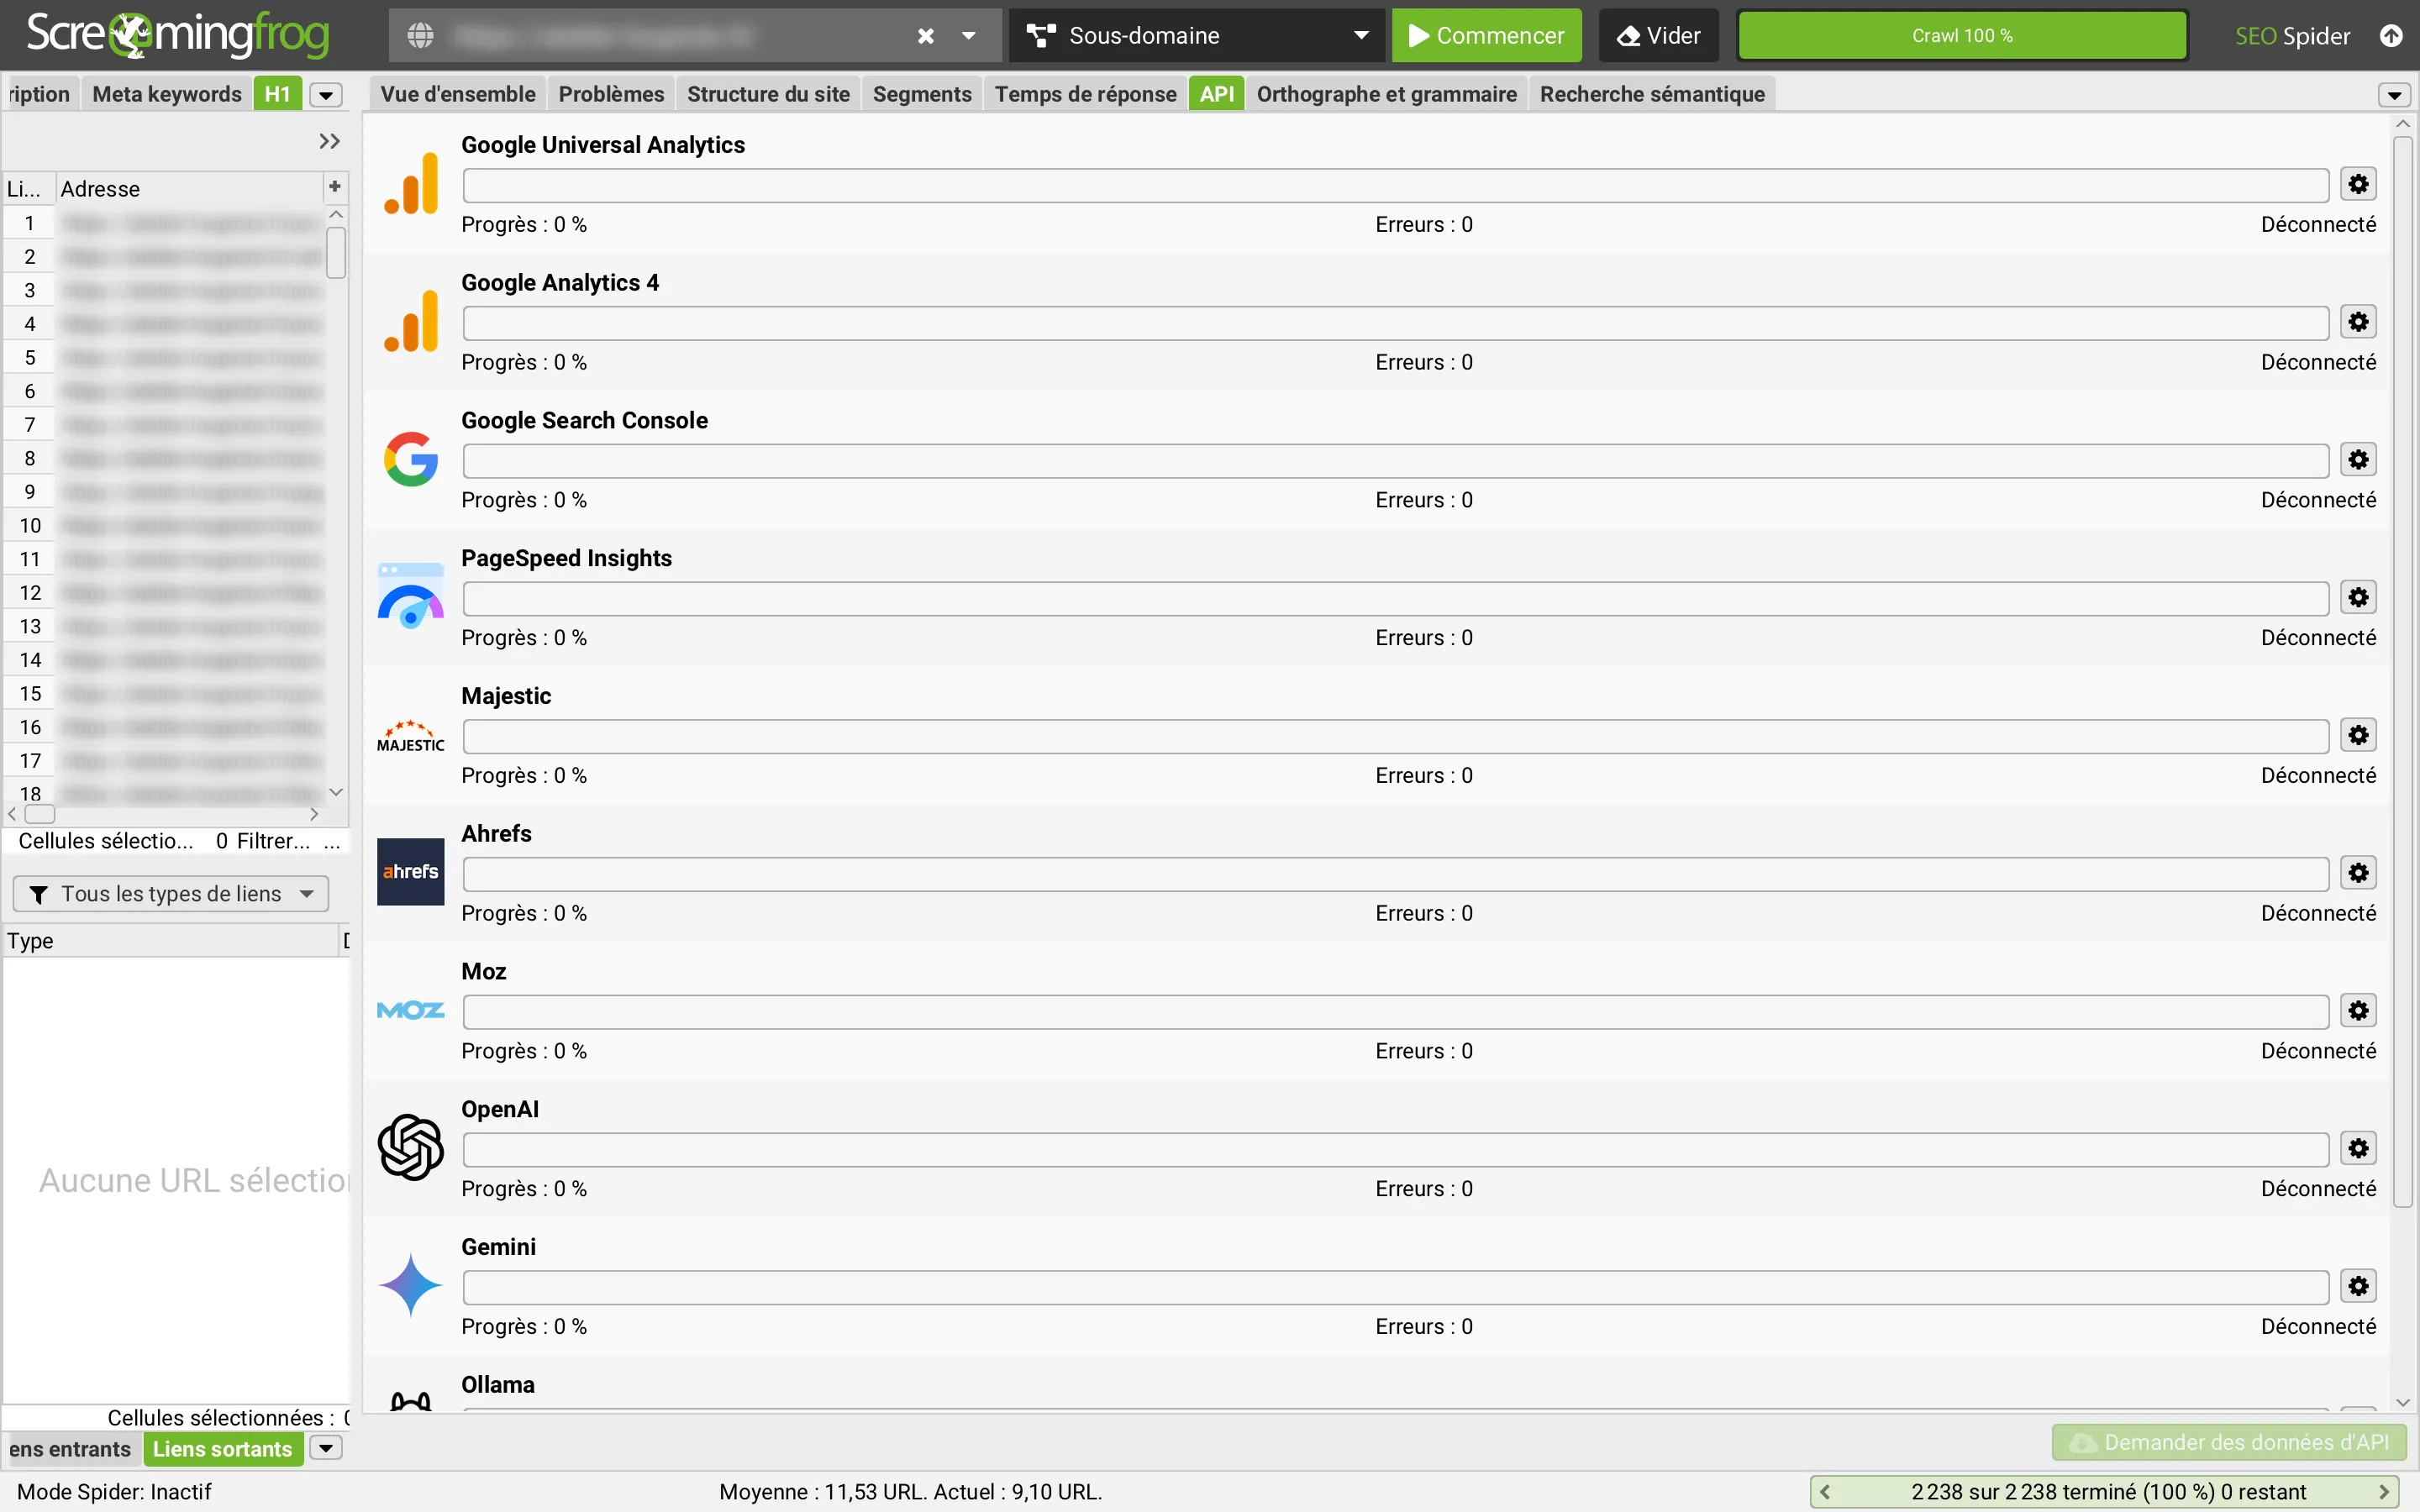
L’intérêt est de lire sur la même ligne l’état technique d’une page et son trafic : une page orpheline qui reçoit des clics ne se traite pas comme une page orpheline sans visite. Un mode APIs récupère même ces données sans lancer de crawl.
IA : le MCP change mon usage
Depuis la version 24, Screaming Frog a son serveur MCP : tu interroges tes crawls depuis Claude ou un autre assistant IA, en langage naturel. C’est une fonction de la licence payante, et j’en suis presque à n’utiliser l’outil que par lui.
Les versions 22 et 23 avaient déjà ouvert le crawl à l’IA. Tu peux envoyer jusqu’à 100 prompts à OpenAI, Gemini, Anthropic ou Ollama sur les pages crawlées, avec ta propre clé d’API. L’analyse de similarité sémantique, elle, repère les pages trop proches, les contenus hors sujet et les groupes de contenus.
Les limites de Screaming Frog
Je n’ai pas grand-chose à lui reprocher, mais quelques limites sont à connaître avant d’acheter :
- le rendu JavaScript n’est pas fiable à 100 % ;
- c’est un logiciel de bureau : le crawl tourne sur ta machine, et l’éditeur conseille l’outil sous les 2 millions d’URLs, avec 16 Go de RAM et un SSD de 1 To pour les gros sites ;
- la documentation n’existe qu’en anglais, et le support technique est réservé aux licences payantes ;
- l’outil s’adresse à des professionnels : sans bases techniques, sa masse de données est difficile à exploiter.
Le Log File Analyser, moins utile
Le Log File Analyser est un second logiciel, vendu à part : 129 € HT par an, gratuit jusqu’à 1 000 lignes de logs. Il lit les journaux du serveur pour montrer quels robots passent, sur quelles pages et à quelle fréquence.
Je l’ai testé : c’était l’outil des logs, mais il l’est moins aujourd’hui. D’autres outils font l’analyse de logs, comme Cuik, que j’ai testé, et rien ne t’empêche de construire ton propre analyseur.
Les tarifs : 245 € HT par an
La licence du SEO Spider coûte 245 € HT par an et par utilisateur, soit un peu plus de 20 € par mois (screamingfrog.co.uk, relevé le 5 octobre 2026). Le prix baisse avec le nombre de licences : 235 € de 5 à 9, 219 € de 10 à 19 et 209 € à partir de 20.
Une entreprise de l’Union européenne qui donne un numéro de TVA valide ne paie pas la TVA, par autoliquidation. La licence est remboursable sous 14 jours ; à son expiration, le logiciel repasse en version gratuite et les crawls sauvegardés ne s’ouvrent plus.
Pour le crawler que j’utilise sur chaque mission, ce prix est très correct.
La version gratuite, pour un petit site
La version gratuite s’arrête à 500 URLs, et elle ne permet ni de configurer le crawl, ni de le sauvegarder, ni d’activer le rendu JavaScript ou les intégrations. Elle suffit pour un petit site ; au-delà, il faut la licence.
Pour qui est Screaming Frog ?
Screaming Frog est un outil de professionnel :
- un freelance en fait la base de ses audits techniques, pour 245 € HT par an ;
- une agence y trouve de quoi industrialiser ses audits, avec les profils de crawl, la planification, la ligne de commande et des licences dégressives ;
- un propriétaire de site sans bases techniques risque de galérer, et des outils payants pensés pour lui lui conviendront mieux.
Verdict : le crawler de référence
Screaming Frog reste le crawler que je recommande à tout professionnel du SEO : complet sur l’audit technique et vendu à un prix raisonnable. Son MCP l’a même fait entrer dans ma façon de travailler avec l’IA.
Avant d’acheter, lance la version gratuite sur un petit site, ou sur une partie du tien : 500 URLs suffisent pour juger l’outil.